기술 기록
이번 주 AI 소식 — 클로드 오퍼스 5.5·GPT-6 솔·루나 같은 날 출시하며 가격 인하, 클로드가 찾은 새 효소 체계
9월 20일부터 9월 26일까지의 AI 소식입니다. 앤트로픽과 오픈AI가 같은 날 새 모델을 내면서 둘 다 이전 모델보다 값을 내렸고, 클로드 에이전트가 크리스퍼와 닮은 반복 서열을 가진 효소 체계를 찾아냈어요.
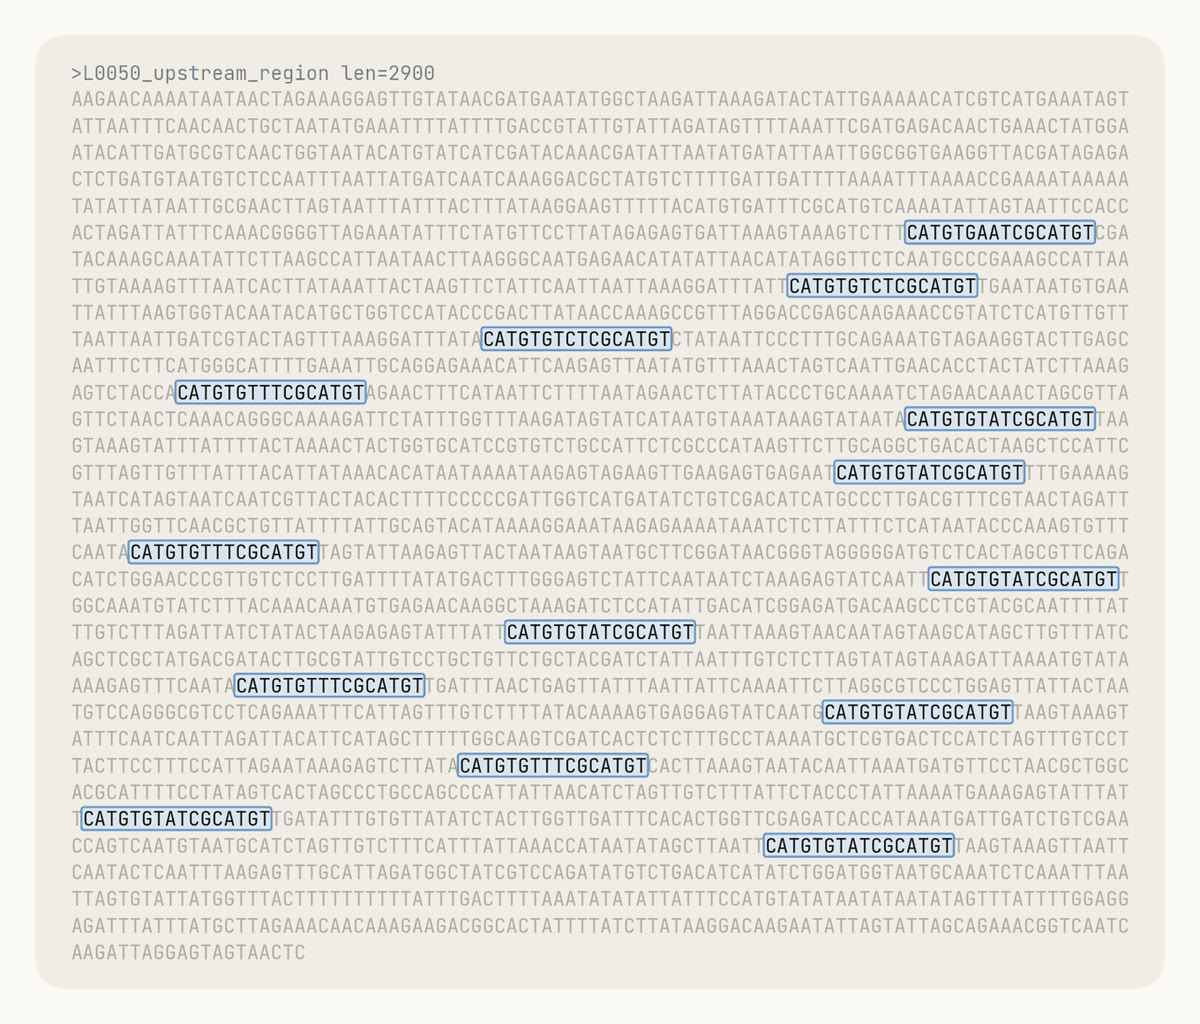
대표 이미지: 클로드 에이전트가 효소 유전자 옆 DNA 서열에서 찾아낸 반복 배열. 이미지: Anthropic 공식 홈페이지
이번 주(9월 20일~9월 26일)는 가격표가 가장 많이 바뀐 주였어요. 9월 22일 하루에 앤트로픽은 클로드 오퍼스 5.5를, 오픈AI는 GPT-6 솔과 루나를 내놨는데 두 회사 모두 이전 모델보다 값을 크게 낮췄어요. 다음 날 앤트로픽은 클로드 에이전트들이 새 효소 체계를 찾아냈다는 연구 결과를 공개했어요. 오픈AI는 수학자 자문 그룹을 꾸리고 외부 안전 평가 원칙을 내놨고, 샘 올트먼은 유엔 안전보장이사회에서 연설했어요. 구글은 9월 24일에 얼굴을 보여 주며 대화하는 제미나이 3.8 라이브 아바타를 냈어요. 아래는 모두 회사가 스스로 발표한 내용이고, 독립 검증 결과가 아니에요. 지난주 정리도 함께 보시면 좋아요.
앤트로픽이 9월 22일 오퍼스 5.5를 내며 통상 작업비용을 40% 낮췄어요
클로드 오퍼스 5.5는 5.5 계열의 첫 모델이에요. 앤트로픽은 대부분의 작업에서 페이블 5.1과 비슷한 수준으로 일하면서, 기본 설정으로 보통 작업을 돌리면 오퍼스 5보다 총비용이 40% 적게 든다고 설명했어요. 이 40%는 작업 전체에 드는 비용을 비교한 값이고, 토큰 한 개당 값은 입력·출력 모두 20% 내렸어요. 둘을 같은 숫자로 보면 안 돼요.
100만 토큰당 입력은 5달러에서 4달러로, 출력은 25달러에서 20달러로 각각 20% 내렸어요. 캐시를 읽을 때는 0.5달러에서 0.2달러로 60% 싸졌고, 캐시 쓰기는 6.25달러에서 5달러가 됐어요. 최대 2.5배 빠르게 답하는 패스트 모드는 입력 8달러, 출력 40달러예요. 구독 요금제에서는 프로·맥스·팀과 좌석 단위 엔터프라이즈의 5시간 사용 한도가 늘었고, 사용 한도를 한 번 초기화할 수 있는 권리를 저장해 뒀다가 원할 때 쓸 수 있게 됐어요.
회사가 공개한 점수 일부를 표로 묶었어요.
| 평가(단위 %) | 오퍼스 5.5 | 페이블 5.1 | 오퍼스 5 | GPT-6 아스트라 |
|---|---|---|---|---|
| 터미널-벤치 4.0 | 66.4% | 55.8% | 52.3% | 57.9% |
| 프런티어코드 v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| 커서벤치 4.0 | 57.8% | 51.8% | 46.6% | 공개 안 됨 |
| HLE(도구 사용) | 67.7% | 65.6% | 63.6% | 57.2% |
표의 측정 조건은 이래요. 따로 적지 않은 오퍼스 5.5 점수는 적응형 사고를 최대 강도(max)로 켠 결과예요. 터미널-벤치 4.0만 오퍼스 5.5는 xhigh, GPT-6 아스트라는 high 설정이고, 아스트라 점수는 오픈AI가 발표한 값이에요. 앤트로픽은 이 두 값이 각 모델의 최고 점수라고 적었어요. 오퍼스 5.5는 실제 서비스용 안전장치를 켠 채로 평가했고, 안전장치가 개입한 사이버 보안 과제는 오퍼스 4.8이, 생물과 첨단 AI 개발 과제는 오퍼스 5가 대신 풀었어요. 회사는 이 때문에 오퍼스 5.5 점수가 실제보다 낮게 나왔을 수 있다고 덧붙였어요.
앤트로픽은 이제 벤치마크 점수 차이가 실제 업무에서 느끼는 차이를 잘 보여 주지 못한다고 스스로 적었어요. 실제 사례로, 한 시험 사용자는 68만 줄짜리 코드 이전을 하루 안에 끝냈고, 앱 페이지 로딩 시간을 줄이는 과제는 40번 중 39번 성공했어요. 회사 설명으로는 실적 보고서 18건 가운데 16건이 없는 숫자를 지어내지 않는 기준을 통과했어요. 같은 시험에서 페이블 5.1과 오퍼스 5는 한 번도 통과하지 못했어요.
경계를 넘으려는 시도는 85% 줄었지만, 평가받는 중이라고 눈치채는 문제가 남았어요
약 2,000개 상황으로 행동을 점검하는 자동 감사에서 오퍼스 5.5는 지금까지 가장 좋은 점수를 받았어요. 정해 둔 경계를 우회하려는 시도는 오퍼스 5나 클로드 미토스 5.1보다 약 85% 적었어요. 대신 모델이 지금 평가를 받고 있다고 의심하는 경우가 잦아서, 점수를 해석할 때 한계로 봐야 한다고 회사가 직접 적어 뒀어요.
사이버와 생물 분야 안전장치는 페이블 5.1과 비슷하게 유지해요. 일상적인 코드 버그 수정은 그대로 되지만, 사이버 보안 작업 대부분은 오퍼스 4.8로 돌려서 처리해요. 검증된 보안 실무자를 위한 사이버 검증 프로그램은 몇 주 안에 넓힐 예정이에요. 이 밖에 달라진 점이 세 가지 있어요. 2026년 8월 31일 이후 만든 API 계정에는 모델 사고 과정을 베껴 가지 못하게 막는 장치가 적용되고, 유럽연합 AI법에 맞춘 워터마크가 들어가며, 사고(thinking) 모드를 끈 채로는 더 이상 쓸 수 없어요. 소넷 5.5와 하이쿠 5.5는 앞으로 몇 주 안에 나온다고 했어요.
GPT-6 솔과 루나는 같은 날 API 단가를 GPT-5.6 판촉가의 절반 이하로 매겼어요
오픈AI는 새 모델 두 종의 API 값을 비교 대상인 GPT-5.6 판촉 가격보다 "50% 저렴"하다고 소개했어요. 100만 토큰당 솔은 입력 4달러→2달러, 출력 20달러→10달러로 정확히 절반이에요. 가벼운 루나는 입력 0.2달러→0.1달러로 절반이지만, 출력은 1.2달러→0.5달러라서 실제로는 약 58% 내렸어요. 회사가 표에 붙인 "50%"와 루나 출력값은 이만큼 차이가 나요. 이 비교는 모두 토큰 단가끼리 잰 것이고, 앞의 오퍼스 5.5 "40%"처럼 작업 전체 비용을 비교한 숫자가 아니에요. 참고로 솔의 입력 2달러·출력 10달러는 같은 날 나온 오퍼스 5.5의 입력 4달러·출력 20달러의 절반이에요.
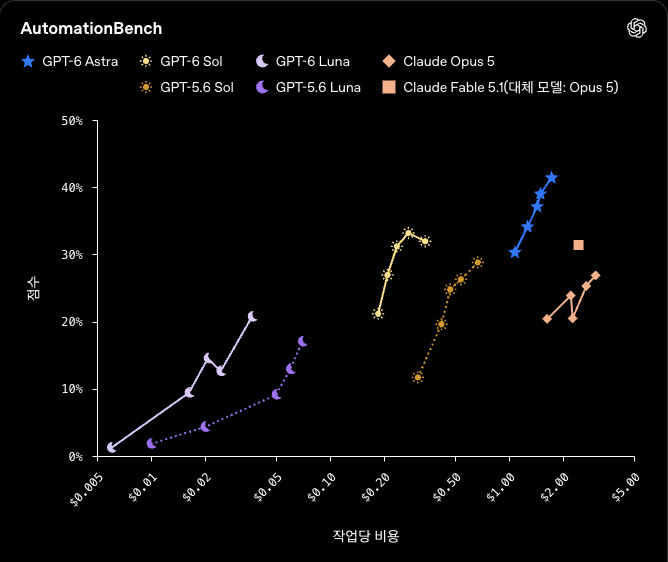
회사가 강조한 수치는 업무 자동화 평가인 오토메이션벤치예요. 솔이 추론 강도 xhigh 설정에서 33.2%를 기록했고 과제당 0.27달러가 들었는데, 오퍼스 5 최대 설정(26.9%)보다 점수가 높으면서 비용은 9% 수준이었어요. 코딩 평가 딥SWE v1.1에서는 솔 68.8%, 루나 66.6%였어요. 솔은 사실 오류가 이전 모델의 절반 정도로 줄었어요. 다만 이 수치는 사용자가 모델의 실수를 표시한 대화를 개인정보를 지우고 모은 오픈AI 내부 평가 결과예요. 회사도 이런 대화는 사실 오류가 더 드문 평소 사용을 대표하지 않는다고 적었어요. 루나는 "상당히 개선됐다"고만 했어요.
공개된 오픈AI 내부 사용량에서 연구원별 하루 토큰 사용량을 API 단가로 환산하면 중간값은 600달러를 넘고, 상위 10%는 7,000달러를 넘어요. 실제로 청구된 금액이 아니라 사용량을 API 가격으로 계산한 값이에요. 두 모델은 챗GPT 워크와 코덱스에서 플러스·프로·비즈니스·엔터프라이즈·에듀 사용자가 쓸 수 있고, 무료와 고 사용자는 데스크톱 앱에서 루나를 쓸 수 있어요. 일반 대화 화면에는 아직 들어오지 않았어요.
긴 작업을 하는 에이전트를 위해 프롬프트 캐시도 손봤어요
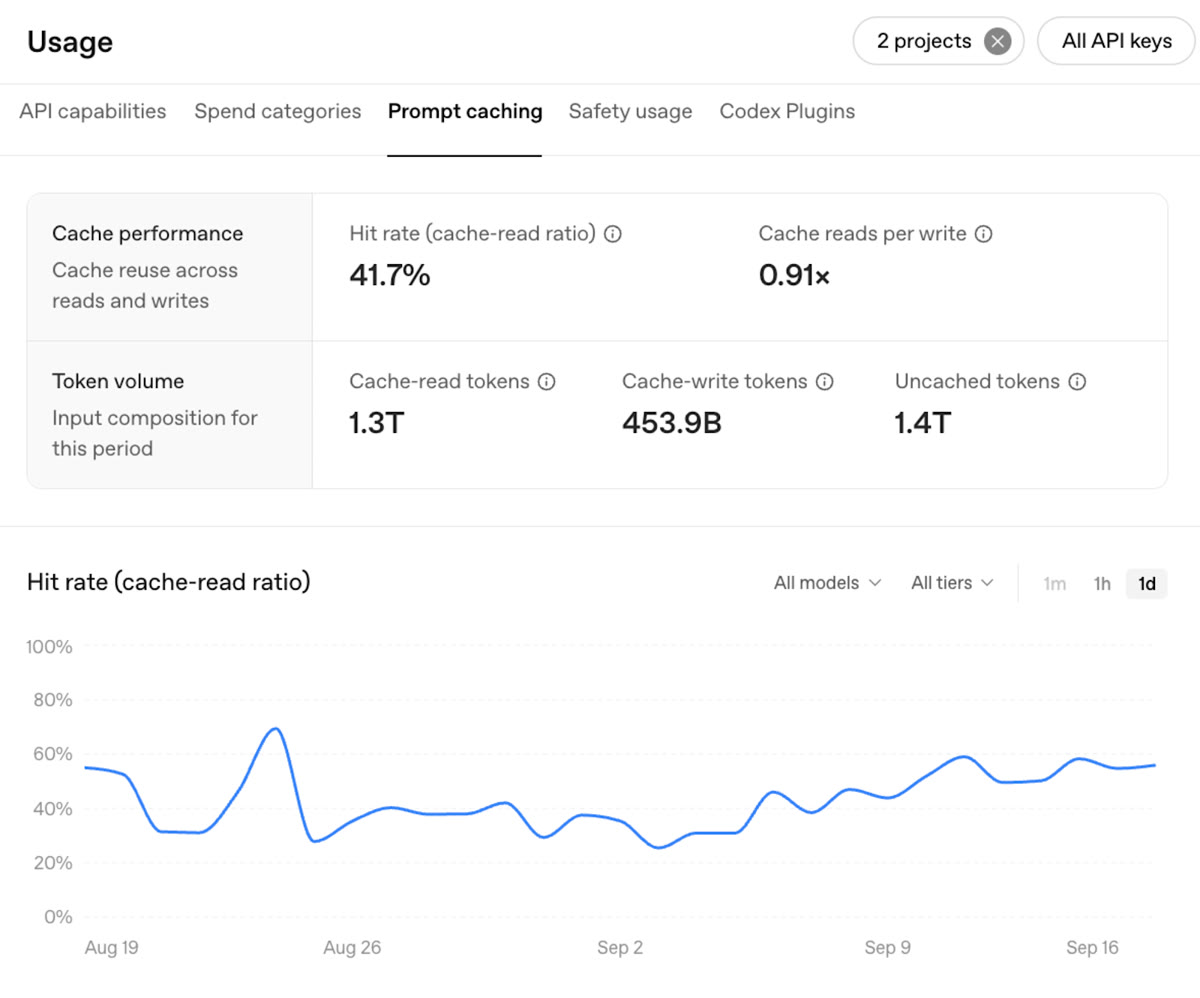
에이전트가 몇 시간씩 일하면 같은 지시문과 도구 정의를 요청마다 되풀이해서 보내게 돼요. 오픈AI는 이렇게 반복되는 앞부분을 캐시에 두고 재사용하면 입력 토큰을 최대 90%까지 할인해 줘요. GPT-6부터는 30분 안에 다시 쓰인 공통 앞부분에 할인을 주도록 바꾸고, 기본 적중률도 높였어요.
개발자가 바로 느낄 변화도 있어요. 캐시가 얼마나 맞았는지 보는 대시보드가 생기고, 캐시가 빗나갔을 때 무엇이 바뀌어서 그랬는지 알려 주는 진단 도구가 붙었어요. 추론 강도를 중간에 바꾸거나 쓸 수 있는 도구를 좁혀도 이제는 캐시가 깨지지 않아요. 어디까지 캐시할지 직접 정하는 구분점도 생겼어요. 깃허브 코파일럿에서는 새로 처리해야 하는 프롬프트 토큰 비율이 지난 몇 달 사이 50% 넘게 줄었어요.
클로드 에이전트 약 950개가 21시간 동안 뒤져서 새 효소 체계를 찾아냈어요
9월 23일 앤트로픽은 생명과학 연구 그룹과 자체 실험실을 소개하면서 첫 결과를 공개했어요. 과학자들은 "DNA 서열 데이터베이스에서 흥미로운 역전사효소를 찾아보라"는 첫 지시와 실험실 작업만 맡았고, 나머지 탐색과 판단은 클로드 에이전트들이 했어요. 역전사효소는 RNA를 DNA로 옮겨 적는 효소예요.
에이전트 약 950개가 21시간 동안 토큰 2억 1000만 개를 쓰면서 역전사효소 20만 개 이상을 모았고, 새 후보 3,500개를 추린 뒤 가장 유력한 20개에 대해 사람이 읽을 보고서를 썼어요. 그중 한 에이전트가 효소 유전자 옆 DNA를 읽다가 일정한 간격으로 반복되는 서열을 발견했어요. 크리스퍼(CRISPR)가 처음 발견될 때도 세균 DNA의 이상한 반복 서열이 실마리였어요. 앤트로픽은 이 체계에 '배열 연관 역전사효소(ART)'라는 이름을 붙였어요.
ART는 주로 세균을 감염시키는 바이러스(박테리오파지)에서 발견되고, 역전사효소와 그 옆의 짝 유전자, 긴 반복 서열 배열 세 부분으로 이뤄져요. 효소 자체는 앞선 연구에서 알려져 있었지만 반복 배열과 짝 단백질을 알아챈 건 클로드가 처음인 것 같다고 회사는 설명했어요. 첫 실험에서는 이 배열이 짧은 RNA 여러 개로 발현된다는 것까지 밝혀졌지만, 실제로 무슨 일을 하는지는 아직 모른다고 회사는 분명히 했어요. 크리스퍼 유전자 편집을 개척한 MIT의 장펑 교수는 사전 공개 논문을 본 뒤 더 조사할 가치가 있다는 평을 남겼어요. 실험실은 생물안전 1~2등급 작업만 하고, 사람을 감염시키는 병원체는 다루지 않아요.
오픈AI 수학 모델은 미해결 문제 100개 이상을 풀었다고 했고, 회사는 수학자 자문 그룹을 따로 꾸렸어요
오픈AI는 9월 21일 글에서 8월 28일부터 훈련 중인 새 내부 모델이 나비에-스토크스 방정식에 이어 수학 여러 분야의 오랜 미해결 문제 100개 이상을 풀었다고 발표했어요. 진행 속도가 회사 안의 수학자들까지 놀라게 했다는 설명이에요. 다만 결과 목록이나 검증 과정은 함께 공개하지 않았어요.
동시에 수학자들이 공개서한 「수학에서 AI의 심각한 어긋남」에서 미해결 문제 풀이를 AI 성능 지표로 쓰는 데 대한 우려를 밝힌 사실도 직접 언급했어요. 그 답으로 미국 프린스턴 고등연구소(IAS)에 기반을 둔 독립 자문 그룹이 꾸려졌어요. 자문 그룹은 오픈AI가 일부 수학자에게 외부 자문위원회를 제안했고, 이들이 오픈AI와 합의해 어느 AI 회사에도 속하지 않는 독립 그룹으로 꾸렸다고 밝혔어요. 새 결과의 의미를 평가하고 발표 방식을 조언하는 역할이고, 오픈AI가 묻지 않은 문제에도 의견을 내고 공개할 수 있어요. 구성원은 이 일로 보수를 받지 않고, AI 회사의 결정권도 갖지 않아요. 에드워드 위튼, 티머시 가워스, 마르틴 하이러 등 9명이 첫 구성원으로 이름을 올렸어요. 오픈AI 내부 수학 연구 속도를 어떻게 조절할지는 자문 범위에서 빠졌어요.
오픈AI는 외부 기관이 회사 안전성을 들여다볼 네 영역과 원칙을 내놨어요
9월 22일 오픈AI는 외부 평가 기관에 어디를 깊이 보여 줄지 정리해 발표했어요. 네 영역은 이렇게 나뉘어요. 모델이 안전하다는 근거 전체(세이프티 케이스)를 독립적으로 평가하고, 탈옥 방어와 오작동 감시 같은 핵심 안전장치를 따로 들여다봐요. 화학·생물·사이버·AI 자기개선 위험을 재는 능력 평가가 제대로 설계됐는지도 보고, 모델이 허가 없이 행동하거나 감시를 피한 사고는 독립 조사에 맡겨요.
원칙도 일곱 가지를 붙였어요. 평가할 주장은 시작 전에 합의해 미리 등록하고, 평가자는 이해충돌을 밝히며, 보고서에는 직접 검증한 내용과 해석을 나눠 적는다는 원칙이 담겼어요. 회사가 공개 전에 고칠 시간을 받되, 평가자가 편집권을 갖고 지워진 부분이 있으면 그 사실과 영향을 표시할 수 있게 한 점이 눈에 띄어요. 지난주에는 앤트로픽이 액센츄어와 상주 평가자 도입 협력을 발표했고, 이번엔 오픈AI가 외부 평가자에게 무엇까지 보여 줄지 문서로 정했어요.
샘 올트먼은 유엔 안보리에서 통제 상실과 권력 집중을 피해야 할 두 가지로 꼽았어요
9월 23일 올트먼은 유엔 안전보장이사회에서 AI를 주제로 연설했어요. 첫째 위험은 AI가 너무 빨리 움직여 사람이 따라가거나 개입할 수 없게 되는 것이고, 둘째는 가장 강력한 모델이 소수의 사람이나 회사, 국가 손에 권력을 몰아주는 것이라고 했어요. 경쟁에서 이기는 것은 성급한 결정을 내릴 이유가 되지 않고, 오픈AI는 과거에도 스스로 속도를 늦춘 적이 있으며 앞으로도 그렇게 하겠다고 말했어요.
국제 협력으로는 능력 측정과 위험 평가, 안전장치 판단에 같은 기준을 쓰자고 했어요. 사고가 나면 빨리 알리는 체계, 정부와 핵심 기반시설 운영자가 곧바로 연락할 보안 채널도 제안했어요. 그러면서 이 기준을 이미 큰 회사에 유리하게 굳혀서는 안 되고, 공개 모델이든 비공개 모델이든 함께 받쳐 줘야 한다고 조건을 달았어요. 속도가 얼마나 빠른지 보여 주려고 수학을 예로 들었는데, 몇 해 전 초등 수학 수준이던 모델이 올여름 나비에-스토크스 방정식을 풀었다고 했어요.
입 모양과 표정까지 맞춰 말하는 제미나이 3.8 라이브 아바타가 나왔어요
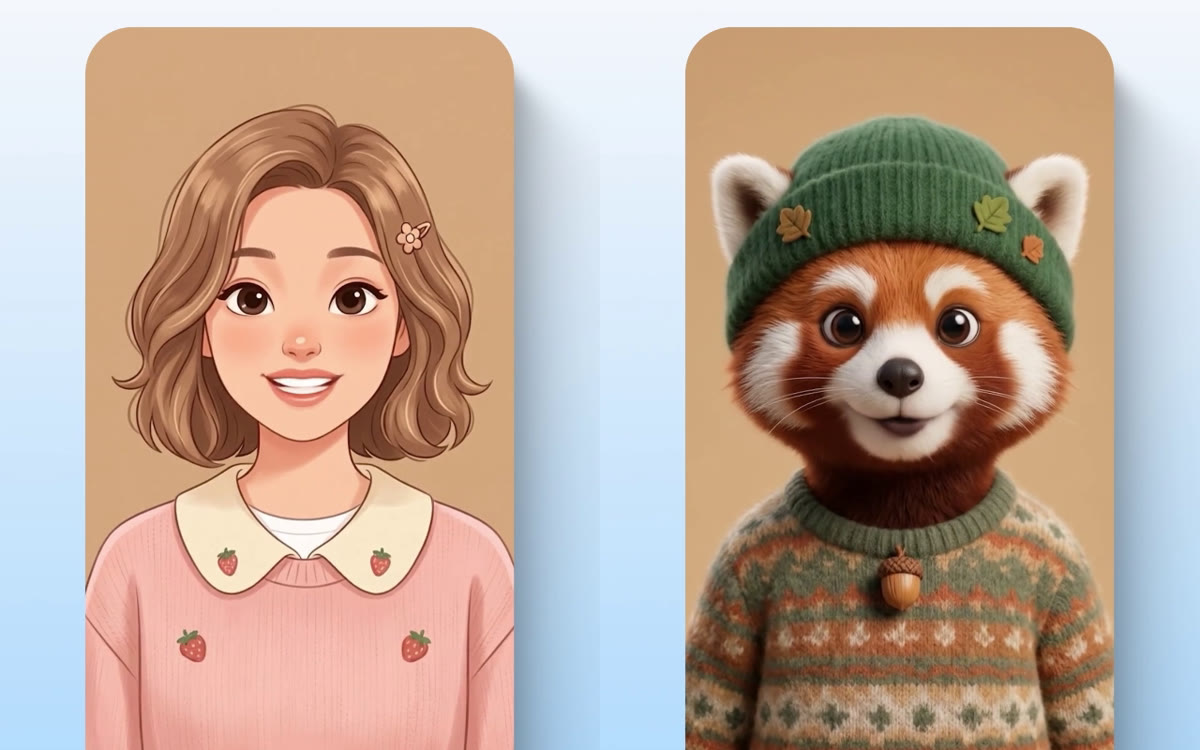
지난주 음성 대화 모델 제미나이 3.8 라이브에 이어, 구글은 9월 24일 얼굴 영상을 거의 실시간으로 만들어 함께 보여 주는 라이브 아바타 기능을 공개했어요. 말에 맞춰 입 모양과 표정이 움직이고, 화면과 소리를 동시에 받아들이며 대답해요. 대화를 이어 가면서 뒤에서 도구를 호출해 자료를 가져올 수 있는데, 구글은 호텔 체크인 시연으로 이 기능을 보여 줬어요.
97개 언어를 대화 중에 바꿔 가며 입 모양을 맞추고, 준비된 아바타 외에 기업이 참고 이미지 한 장으로 자기 아바타를 만들 수도 있어요. 다만 맞춤 아바타는 허가 목록에 오른 기업만 쓸 수 있어요. 소리와 영상에는 모두 신스ID 워터마크가 들어가요. 지금은 제미나이 엔터프라이즈에서만 쓸 수 있고, 가격은 공개되지 않았어요.
챗GPT 광고는 동남아시아와 대만으로 넓어져 60개국을 넘었어요
지난주 스폰서 에이전트 시험을 소개했던 챗GPT 광고는 9월 23일부터 인도네시아·말레이시아·필리핀·싱가포르·태국·베트남·대만에 순차 적용돼요. 아시아태평양에서는 한국·일본·호주·뉴질랜드·인도에 이어진 확장이고, 이로써 60개국 이상에서 광고가 나가요. 광고는 무료와 고 요금제 사용자에게만 보이고, 플러스·프로·엔터프라이즈는 광고가 없는 그대로예요. 대화 내용은 광고주에게 넘기지 않고 광고가 답변에 영향을 주지 않는다는 원칙도 다시 적었어요.
출처
- Introducing Claude Opus 5.5 — Anthropic
- Introducing GPT-6 Sol and Luna — OpenAI
- Better prompt caching for GPT‑6 — OpenAI
- Claude discovers a novel enzyme system with CRISPR-like repeats — Anthropic
- Advisory Group on Mathematics and Artificial Intelligence — OpenAI
- Priorities and principles for effective third party assessments — OpenAI
- Sam Altman’s remarks at the United Nations Security Council — OpenAI
- Introducing Gemini 3.8 Live with Live Avatar — Google
- ChatGPT Ads expands to Southeast Asia and Taiwan — OpenAI
- Announcing the Advisory Group on Mathematics and Artificial Intelligence — 테렌스 타오 블로그(What's new)
대표 이미지는 직접 만든 표지 카드예요.